

Strefa open source dla 11 państw BRICS. Xi ogłosił ją w Delhi, Indie zachowują dystans
Na drugiej sesji szczytu BRICS w Nowym Delhi Xi Jinping przedstawił pięć inicjatyw. Pierwszą jest wspólna strefa otwartych modeli sztucznej inteligencji: szkolenia, wsparcie dla dużych modeli językowych, otwarty ekosystem. Deklaracja końcowa szczytu propozycji nie przyjęła — tylko ją odnotowała.
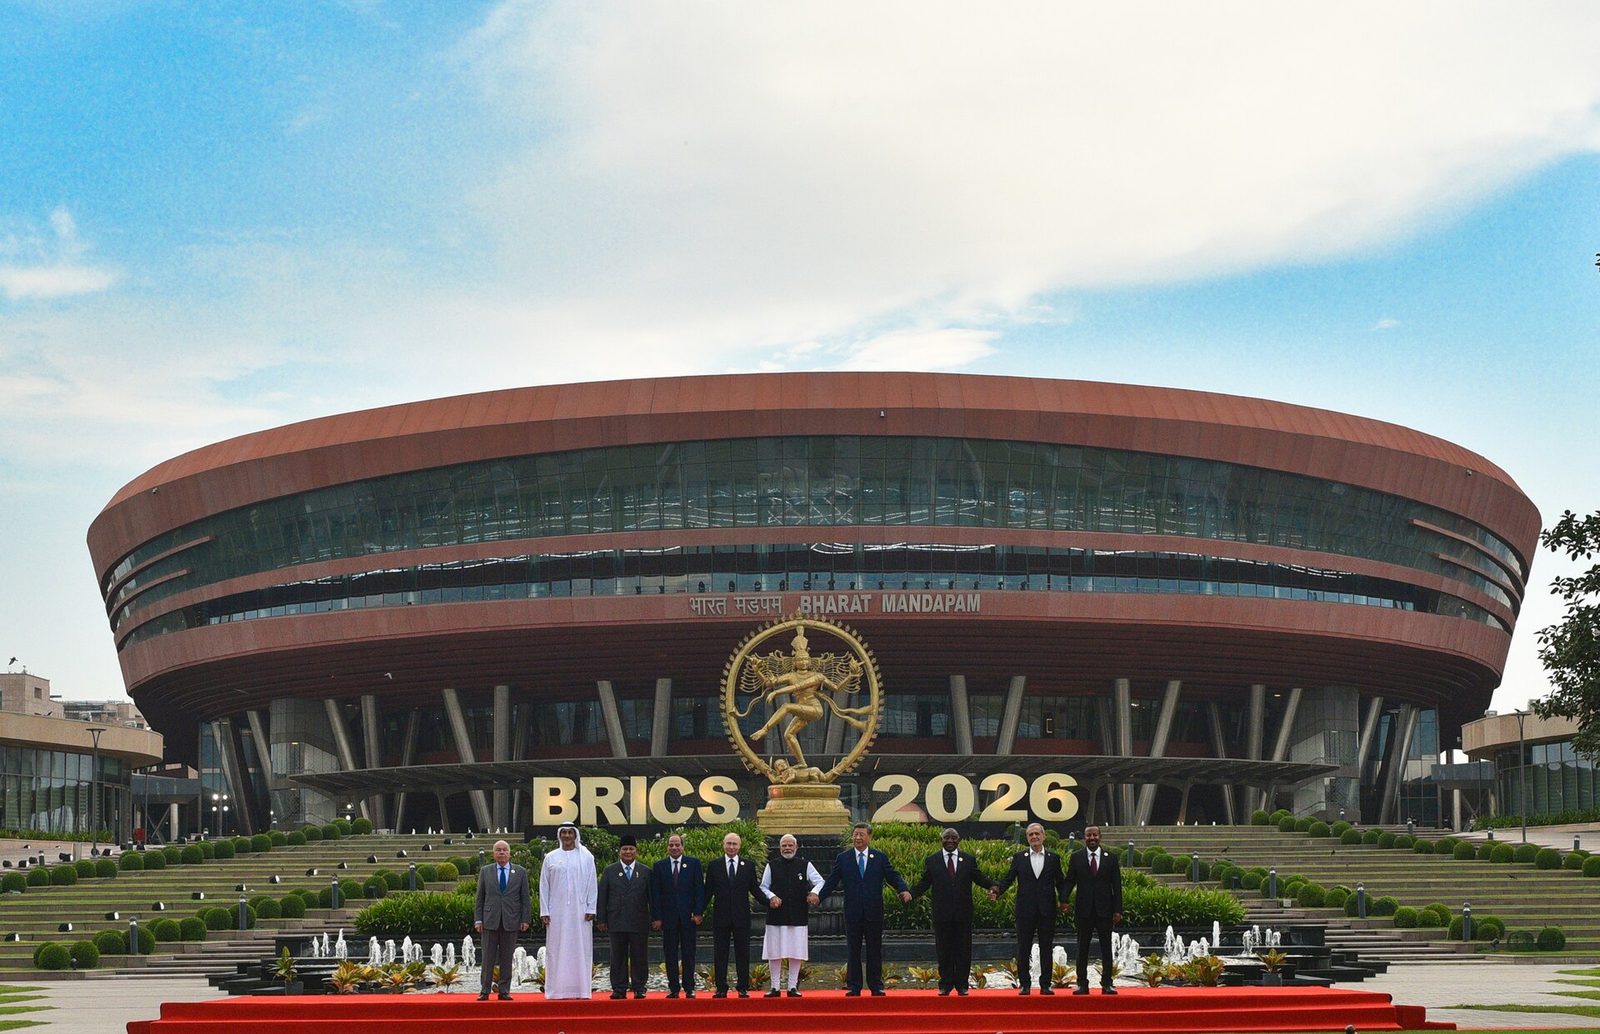
13 września na drugiej sesji XVIII szczytu BRICS w Nowym Delhi Xi Jinping wymienił pięć inicjatyw. Pierwszą, wedle kolejności z zapisu przemówienia opublikowanego przez agencję Xinhua, jest „inicjatywa otwartego i powszechnie dostępnego kodu w sztucznej inteligencji".
Zapis mówi dosłownie: strona chińska „jako pierwsza zbuduje strefę otwartego kodu sztucznej inteligencji państw BRICS, wesprze współpracę przy tworzeniu i wdrażaniu dużych modeli językowych, poprowadzi tematyczne szkolenia z AI i zbuduje otwarty ekosystem". Cztery elementy, żadnych kwot, żadnego harmonogramu.
Pozostałe cztery dotyczą handlu i inwestycji (partnerstwo specjalnych stref ekonomicznych, forum handlu usługami w 2027 roku), współpracy cyfrowej, inteligentnej produkcji oraz kadr — z Sojuszem Kształcenia Inżynierów BRICS i wzajemnym uznawaniem kwalifikacji.
To nie jest pierwszy ruch w tej samej sprawie
Propozycja z Delhi domyka coś, co zaczęło się dwa miesiące wcześniej. 16 lipca 2026 roku w Szanghaju przedstawiciele 29 państw podpisali — w obecności sekretarza generalnego ONZ Antónia Guterresa — porozumienie powołujące Światową Organizację Współpracy ds. Sztucznej Inteligencji z siedzibą w tym mieście. Dzień później padła zapowiedź 5 tysięcy miejsc szkoleniowych dla krajów rozwijających się w ciągu pięciu lat i centrów wdrożeń dla ASEAN, Ligi Arabskiej, Unii Afrykańskiej, CELAC, Szanghajskiej Organizacji Współpracy i BRICS.
Strefa open source to kolejne piętro tej samej konstrukcji, adresowane do bloku 11 państw, który ma własny szczyt, własną deklarację i własne spory.
Za propozycją stoi realna przewaga w otwartych modelach
Oferta nie jest pusta, bo w kategorii modeli z udostępnionymi wagami przewaga jest policzalna. Z zestawienia Hugging Face, największej platformy hostującej modele, z 14 sierpnia 2026 roku wynika, że rodzina Qwen ma 151 448 modeli pochodnych — modele Google'a 82 506, a Llama od Mety 32 244.
Istotniejsze od pobrań są licencje. Wśród wydań powyżej 20 miliardów parametrów z laboratoriów w Hangzhou, Pekinie i Szanghaju 59 procent ze 178 modeli wyszło na Apache 2.0, a 22 procent na MIT — czyli z prawem do komercyjnego użycia bez niczyjej zgody. W wydaniach amerykańskich tej samej wielkości Apache i MIT to 29 procent, a 41 procent modeli objęto warunkami własnymi. Wyjątki pojawiły się i po drugiej stronie: Kimi-K3 i największy Qwen 3.8 dostały ograniczenia niekomercyjne.
Otwarte wagi to nie to samo co otwarty kod
Tu zaczyna się pierwszy problem z nazwą inicjatywy. DeepSeek, Qwen czy GLM udostępniają wagi — gotowy model do pobrania, uruchomienia i dostrojenia. Nie udostępniają zbiorów treningowych, kodu treningowego ani opisu czyszczenia danych. W klasycznej definicji otwartego oprogramowania to za mało; poprawna nazwa brzmi „otwarte wagi".
Różnica nie jest akademicka, bo to w wagach siedzą decyzje, których nie widać. Bratysławski Central European Institute of Asian Studies opublikował 3 lipca 2026 roku badanie Veroniki Blablovej: 5760 pytań o 37 krajów i 40 tematów, zadanych czterem modelom (DeepSeek V3.2, Kimi K2.5, Qwen 3.5, GLM-5) po angielsku i po mandaryńsku.
Spośród 160 odpowiedzi o Tajwan 81 procent nosiło wyraźne ślady cenzury politycznej, z dużym rozrzutem między modelami: od 97,5 procent u Qwena do 50 procent w GLM-5. Na wszystkich pytaniach politycznych Kimi przełączał się w tryb unikowy mniej więcej w co trzeciej odpowiedzi, DeepSeek w co czwartej. Najmocniejsza obserwacja dotyczy języka: na dziesięciu najbardziej drażliwych tematach odsetek zniekształconych odpowiedzi rósł z 24 procent po angielsku do 59 procent po mandaryńsku.
Kto bierze wagi, bierze też to. Dostrojenie na własnych danych nie usuwa tego automatycznie i żadna etykieta o tym nie informuje.
Deklaracja szczytu propozycji nie przyjęła
Drugi problem widać w dokumencie końcowym. Deklaracja z Nowego Delhi mówi o sztucznej inteligencji ogólnie — że „daje ogromne możliwości wzrostu gospodarczego i zrównoważonego rozwoju" — i pozytywnie ocenia lipcową konferencję w Szanghaju. Samą propozycję traktuje ostrożniej: „odnotowuje" pomysł sieci współpracy ekosystemu cyfrowego z portalem informacyjnym. Odnotowuje, nie przyjmuje. W języku szczytów to wyraźna różnica.
Powód jest prozaiczny. Delhi ma z Pekinem rekordowy deficyt handlowy: 112,6 mld dolarów w roku budżetowym 2025/26 wobec 99,2 mld rok wcześniej. Dane o obrotach różnią się między źródłami — 151,1 mld dolarów albo 127,7 mld, zależnie od liczenia roku fiskalnego i reeksportu — ale kierunek nierównowagi jest bezsporny.
Indie prowadzą przy tym własny program IndiaAI Mission, nastawiony na suwerenne moce obliczeniowe i rodzime modele multimodalne, a w lutym 2026 roku gospodarowały w tym samym Bharat Mandapam szczytowi India AI Impact Summit. Oparcie architektury cyfrowej na cudzych modelach byłoby dla nich zamianą jednej zależności na drugą — i to na tę, z którą mają otwarty spór graniczny.
Xi ma w drugiej połowie września lecieć do Stanów Zjednoczonych na rozmowy z Donaldem Trumpem; zarządzanie sztuczną inteligencją ma być jednym z tematów. Propozycja z Delhi jest w tym układzie kartą, którą właśnie położono na stole — tyle że jej główny adresat jeszcze jej nie podniósł.
Źródła: Euronews, Xinhua: zapis przemówienia, Xinhua: relacja, Xinhua: deklaracja, Caixin, Hugging Face: State of Open Models, CEIAS, CNBC, Business Standard